Bude AI video opravdu vypadat jako váš produkt? Rozhodují podklady, ne prompt.
Současné modely mohou udržet tvar, barvu i logo produktu napříč záběry. Potřebují ale vidět všechny důležité strany, detaily a skutečné měřítko. Co v podkladech chybí, musí dopočítat — a právě tam vznikají rozdíly.
- AI VIDEO
- PRODUKT
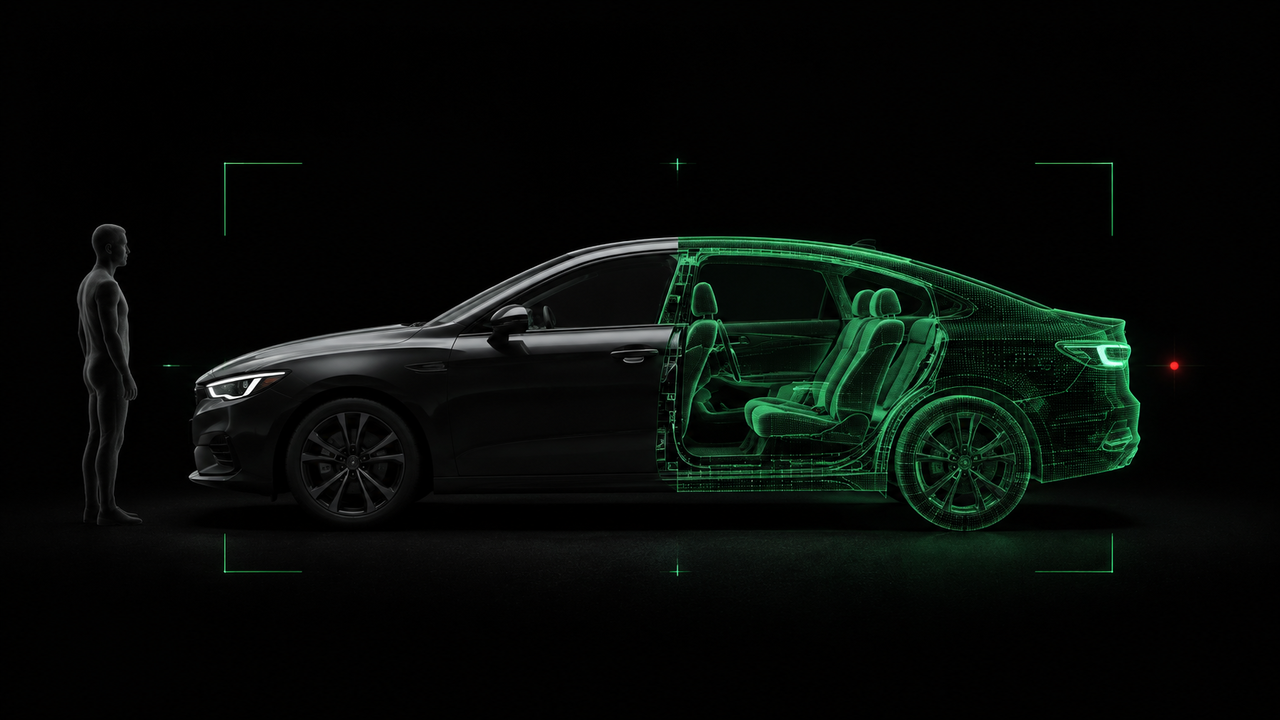
Telefon v prvním záběru sedí. Má správný tvar, barvu i logo. Pak ho vezme člověk do ruky a najednou působí jako tablet. U auta je problém ještě viditelnější: zvenku odpovídá předloze, ale po otevření dveří má jiný volant, palubní desku a materiál sedadel.
Tohle většinou není problém jednoho špatného slova v promptu. Model dostal málo informací a zbytek si dopočítal. Pokud má produkt ve videu zůstat skutečně vaším produktem, potřebuje referenční sadu, ne jednu hezkou fotografii.
Stačí pro AI video jedna produktová fotografie?
Jedna fotografie stačí jen tehdy, když se produkt ukáže z podobného úhlu a žádný záběr neodhalí jeho další strany. Jakmile se má kamera otočit, produkt otevřít nebo ho má někdo vzít do ruky, jeden packshot přestává být úplným zadáním.
Fotografie říká modelu, co je na ní. Neříká mu spolehlivě, jak vypadá zadní strana telefonu, spodní část lahve nebo ovládání uvnitř auta. Chybějící plochy proto musí vytvořit. Výsledek může působit uvěřitelně, ale není to totéž jako shoda s výrobkem.
Při přípravě produktového videa proto nejdřív rozepíšu záběry a až podle nich určím, které části výrobku musí být v podkladech vidět. Čelní detail loga potřebuje jinou referenci než pohled zezadu. Záběr na otevírání víčka zase potřebuje vidět závit, uzávěr i materiál pod ním. Nejde o počet fotek pro počet fotek. Jde o pokrytí toho, co má kamera odhalit.
Proč jsou automobily pro AI video tak náročné?
Automobil není jeden objekt zvenku. Je to exteriér, interiér a desítky detailů, které divák zná a rychle pozná: tvar světel, maska, kola, kliky, volant, displeje, šití sedadel nebo ovládací prvky.
Pro záběry karoserie potřebuji přední, zadní a boční pohledy ve stejné konfiguraci vozu. Stejný lak, stejná kola, stejná výbava. Detail znaku nebo světlometu dostane vlastní fotografii, pokud má být v obraze dost velký. Pro pohled dovnitř potřebuji samostatně kokpit, sedadla, dveře a další části, které se v konkrétním záběru objeví.
Když se má kamera přesunout zvenku do kabiny, nestačí přední fotografie auta a věta „kamera vjede dovnitř“. Model neviděl, co je za sklem a dveřmi. Může vytvořit pěkný interiér, ale není důvod, aby vytvořil právě ten správný.
Tady se také rozhoduje, jestli dává generativní video smysl. Pokud značka nemá fotografie interiéru a potřebuje přesně ukázat konkrétní výbavu, prompt chybějící podklady nenahradí. Řešením je materiál doplnit, použít existující 3D data, nebo záběr postavit jinak.
Jak model pozná, kterou referenci má použít?
Každá reference musí mít v zadání jasnou roli. Jedna určuje karoserii, druhá konkrétní kolo, třetí palubní desku. U každého záběru pak popíšu, která reference řídí který prvek a co se na něm nesmí měnit.
Současné systémy už takový postup podporují přímo. Společnost Kuaishou při uvedení Kling AI 3.0 v únoru 2026 popsala práci s více obrazovými a video referencemi pro konzistenci postav, objektů a scén. ByteDance u Seedance 2.5 v červenci 2026 ukazuje zadání, ve kterém jsou jednotlivé reference přiřazené konkrétním postavám, kompozici i pohybu kamery. To jsou schopnosti deklarované výrobci, ne záruka shody v každé generaci. (Kuaishou, 5. 2. 2026, ByteDance, 31. 7. 2026)
Více podkladů proto neznamená naházet do generátoru celou složku fotografií. Když není jasné, k čemu která slouží, přidává se další prostor pro záměnu. Nejdřív záběr, potom potřebné prvky, nakonec jejich reference.
Jak udržet správnou velikost telefonu nebo lahve?
Do podkladů patří skutečné rozměry a alespoň jedna fotografie produktu v měřítku. U telefonu to může být snímek v ruce, u lahve vedle ruky nebo předmětu s jasně danou velikostí. Samotný packshot na prázdném pozadí ukazuje proporce, ale neříká spolehlivě, jak je výrobek velký v reálném prostoru.
Nejde jen o zvláštnost generativních modelů. Určení absolutního měřítka z jediného obrazu je dlouhodobý problém počítačového vidění: bez informace o scéně a kameře zůstává velikost nejednoznačná. Výzkum prezentovaný na ICCV v roce 2019 například popisuje, že výšku člověka z jedné fotografie lze bez informace o absolutním měřítku jen odhadovat s velkou nejistotou. (Gunel, Rhodin a Fua, ICCV 2019)
Proto kombinuju obojí. Rozměry z technického listu definují skutečnou velikost. Fotografie v ruce ukazuje, jak se má tato velikost projevit v konkrétní scéně. Číslo popisuje předmět. Ruka ho zasadí do reality.
Co má obsahovat referenční sada produktu?
Neexistuje jeden počet fotografií pro každý výrobek. Sada se odvozuje od scénáře, ale obvykle obsahuje pět druhů podkladů:
- Hlavní podobu produktu — čistý snímek, podle kterého se drží tvar, barva a materiál.
- Úhly, které odhalí konstrukci — přední, zadní, boční, horní nebo spodní pohled podle toho, co kamera ve videu uvidí.
- Detaily značky a ovládání — logo, etiketa, tlačítka, konektory, displej nebo šití, pokud mají být čitelné.
- Měřítko — rozměry z technického listu a fotografie vedle ruky, člověka nebo známého předmětu.
- Vnitřek a pohyblivé části — všechno, co se má otevřít, otočit nebo ukázat zevnitř.
Fotografie mají zachycovat stejnou variantu produktu. Když má jedna láhev jinou etiketu a auto na různých snímcích jiná kola, model nedostal více informací o jednom výrobku. Dostal několik výrobků a musí hádat, který platí.
Znamenají dobré podklady stoprocentní shodu?
Ne. Dobrá referenční sada omezuje prostor, ve kterém model hádá, ale nepromění generativní video v technický 3D model. Malé nápisy, jemná geometrie, odrazy, zakryté části a mechanické chování pořád vyžadují kontrolu záběr po záběru. Kritické logo nebo etiketu je někdy jistější doplnit v postprodukci než doufat, že přežije každý pohyb kamery.
Stejně opatrný jsem u funkce výrobku. Výzkumný benchmark VideoPhy-2 z roku 2025 ukazuje, že generátory stále chybují v běžných fyzikálních vztazích a činnostech. Jestli má video přesně dokazovat, jak se otevírá mechanismus, protéká kapalina nebo pracuje stroj, samotná vizuální podobnost nestačí. (VideoPhy-2, 2025)
Tento limit ovlivňuje i cenu AI reklamního videa. Čas se nespotřebuje jen na generování, ale na přípravu referencí, kontrolu a opravy. U jednoduchého balení může stačit několik jasně naplánovaných podkladů. U automobilu se referenční sada stává samostatnou částí produkce.
Co má značka připravit před výrobou?
Začněte seznamem záběrů, ne exportem celé fotobanky. U každého záběru označte, kterou stranu produktu divák uvidí, který detail musí být přesný, jestli se výrobek něčeho dotýká a podle čeho se pozná jeho velikost.
Z toho vznikne konkrétní seznam chybějících podkladů. Někde bude potřeba zadní pohled, jinde detail etikety nebo fotografie v ruce. A někdy se ukáže, že požadovaný záběr potřebuje 3D data či klasické natáčení. To je užitečné zjistit před první generací, ne až ve střihu.